
Appearance
最佳实践
免费的图片、PDF扫描识别(OCR)
什么是OCR
OCR(Optical Character Recognition),全称是:光学字符识别,是一种将图像中的文字转换为可编辑、可搜索的机器可读文本的技术 。它利用图像处理与模式识别算法,把纸质或图片中的文字“翻译”成计算机能处理的文本数据 。
在老师的日常办公场景中,OCR是不可或缺的一项需求,教材、试卷、论文、作业、参考资料等的文本识别经常需要。为此,Taiwe内置了Taiwe OCR功能,让老师们能够免费的使用,满足日常所需。
Taiwe OCR有什么特点
1、免费
没错,Taiwe为广大老师提供免费的OCR识别服务,不管你是图片还是PDF,都能在本地电脑上进行文本、图片、表格的识别,没有任何限制:没有使用时间上的限制,没有OCR识别次数上的限制,也没有OCR识别页面数量上的限制,全部免费!
Taiwe OCR是运行在本地电脑上的,不需要用到第三方的AI大模型,因此也不会消耗Taiwe用户的词元(Token)使用量。
2、强大的版面识别能力
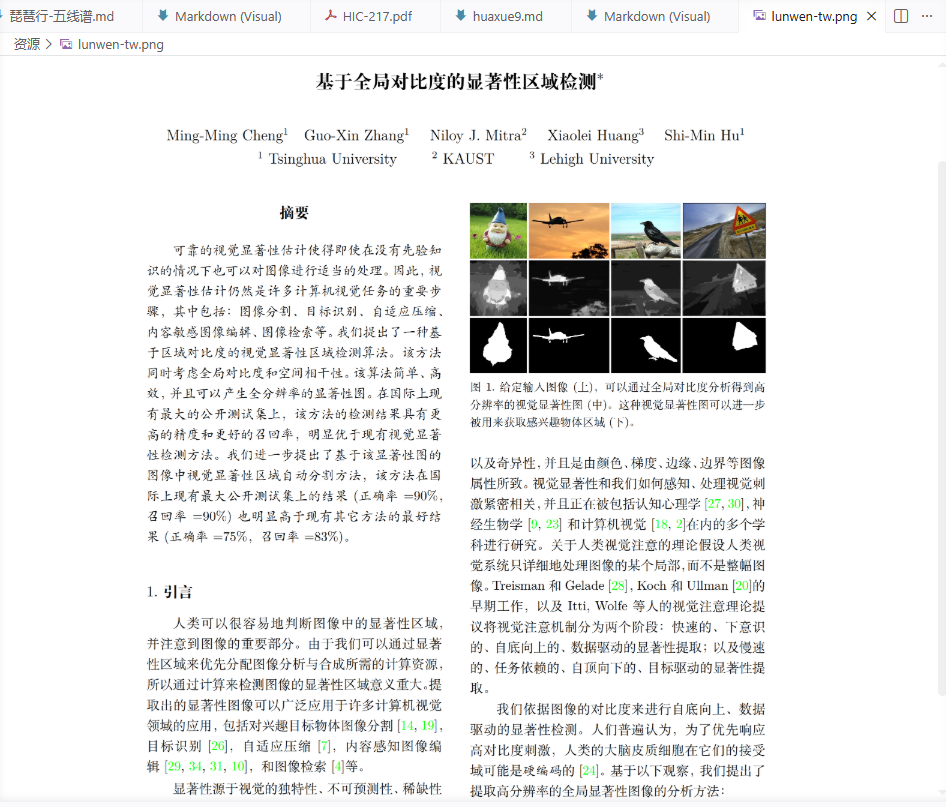
针对老师的日常使用场景,Taiwe使用了pp-doclayoutv3文档版面分析模型,它能够覆盖26中常见版面元素,比如文档标题、段落标题、正文、表格、图片、页眉页脚、公式、参考文献、印章等。此外它还对对卷曲书页、倾斜拍摄、折叠文档、竖排古籍这类非平面图像做了专门优化。
比如下面这个例子,这是典型的学术期刊的论文版面,包括了双栏和图片:
下面是Taiwe OCR识别后的输出,准确的将文本进行编排,并插入图片:
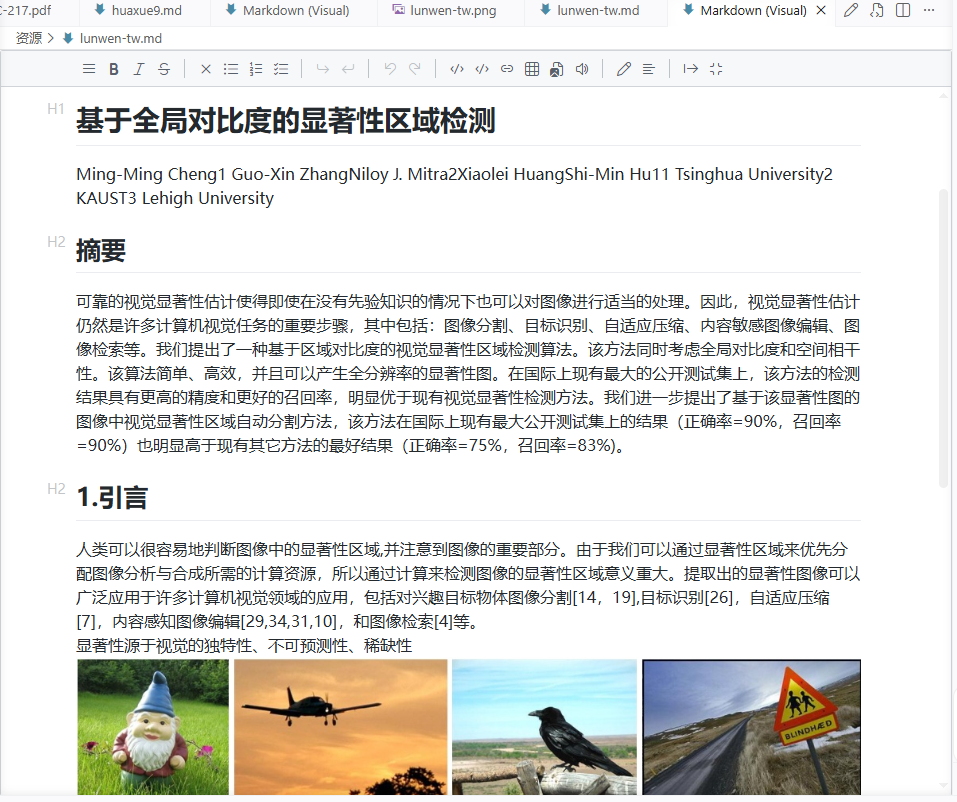
Taiwe的OCR能够准确识别扫描件中的文本、表格、图片,并将识别出的内容,以正常、可读的顺序进行合理排列,生成Markdown格式文档,方便老师和AI助手进行处理。
3、图、表识别能力优秀
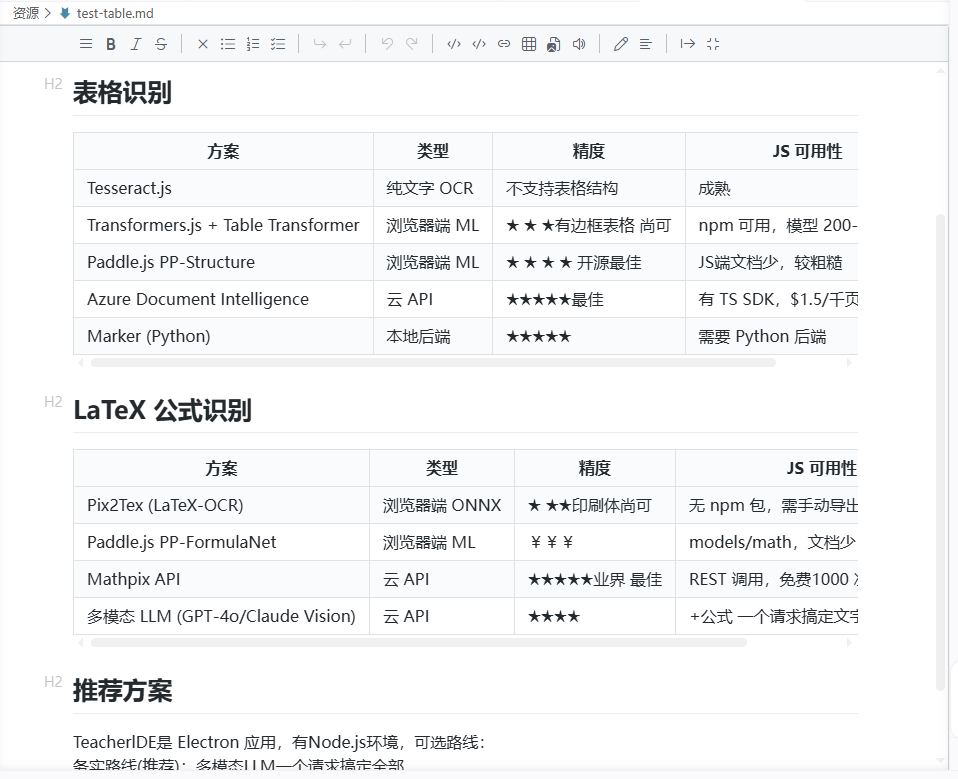
Taiwe OCR不仅仅能够识别图片或者PDF中的文本,更能准确识别出里面的图片,对图片进行精确剪裁,插入输出的文档中。
比如下面这个表格:
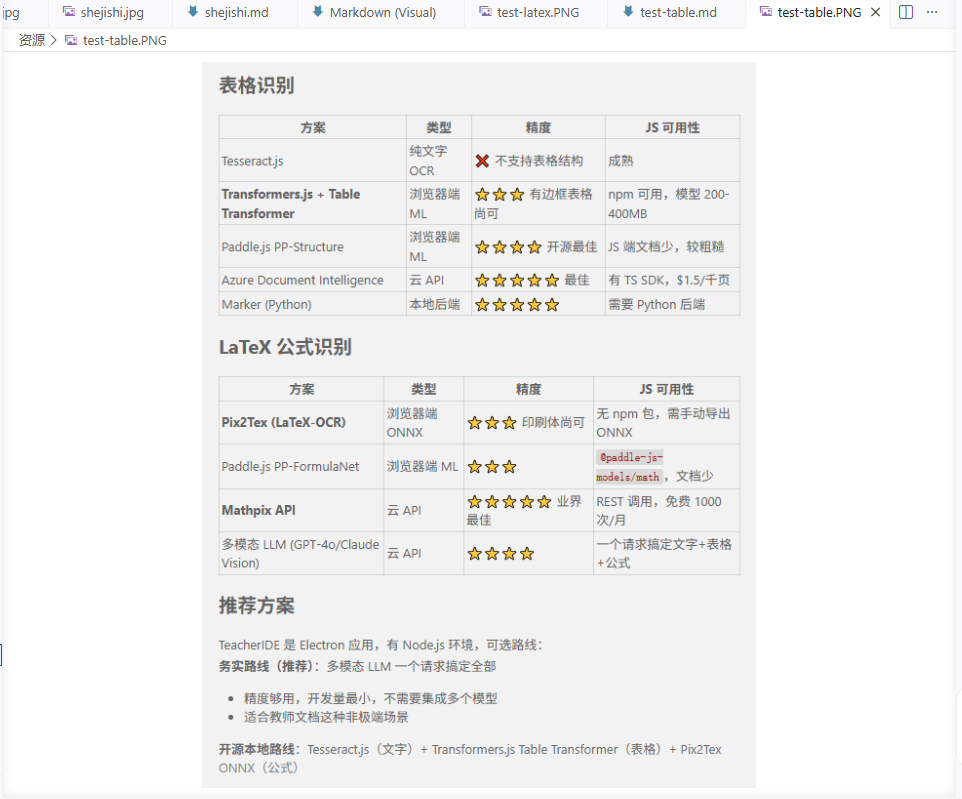
经过Taiwe OCR后输出的结果:
4、文本可读性好
不同于一些图片、PDF的扫描识别,虽然能够输出文本和版面,但是文本本身的可读性较差,特别是要提供给AI进行处理时,错乱的文本会带来不少麻烦。Taiwe OCR有强大的阅读顺序识别能力,输出的文本完全符合文本的阅读顺序(如前图例子),方便老师们日常使用和AI的处理。
5、支持手写识别
不仅电子文本能够正确识别,也支持手写图片的识别,下面是手写识别的例子:
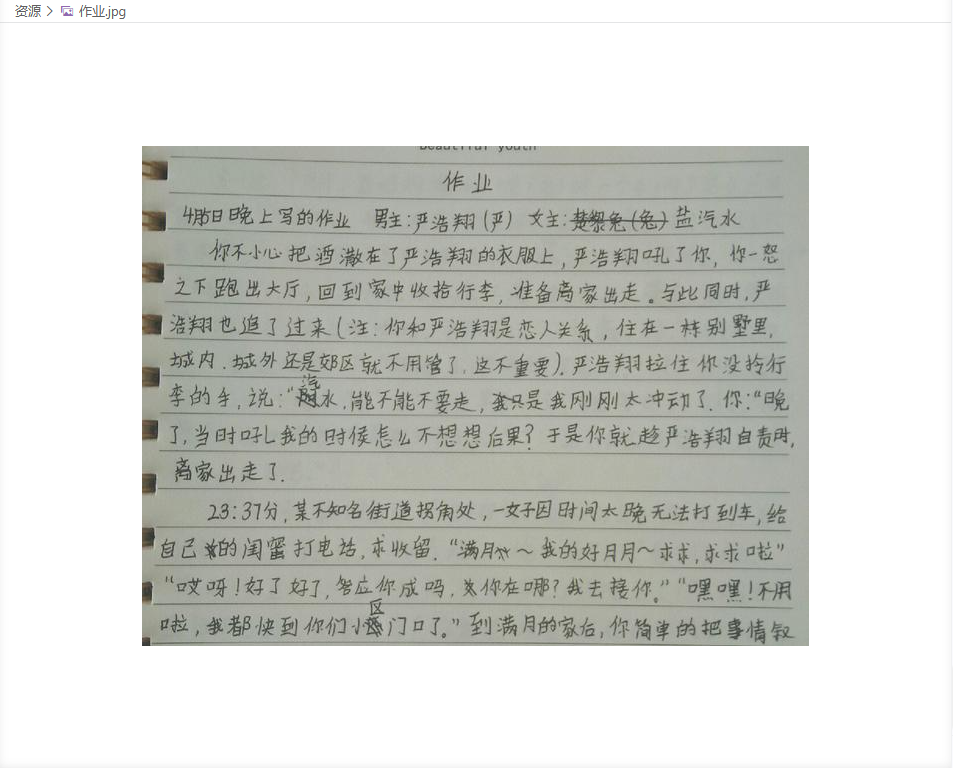
这是一份作文,看看Taiwe OCR的结果:
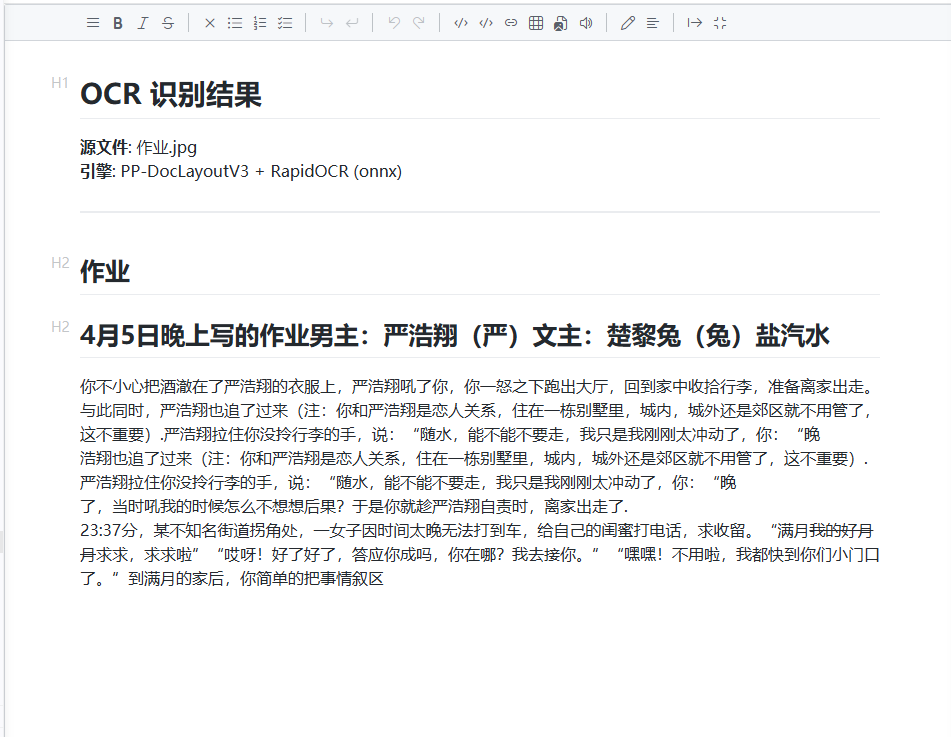
如何使用Taiwe OCR
1、导入
首先,把需要处理的图片、PDF导入到项目的文件夹里。Taiwe OCR支持多种图片格式,包括PNG、JPG扽等。
2、启动识别
然后再要识别的图片或者PDF上点击右键,选择“图片OCR”(图片格式)或者“转成MD格式”(PDF文档),Taiwe OCR就会自动启动进行识别。
首次使用注意,首次使用Taiwe OCR,需要下载识别所需要的依赖和模型库,所以会花费较长时间,这期间你可以先去处理其他事情,它会自己帮您处理好。
3、输出结果
Taiwe OCR输出Markdown格式,它支持表格和图片的显示,因为我们的目的是给老师和AI使用,所以输出时候就不再考虑保持原有的版面,而是以文本可读为优先。
如果PDF本身带有大量图片,Taiwe OCR识别解析的时候,会在同目录下创建新的文件夹,比如你要识别的文档名字是 Demo.pdf,那么这个文件夹名会是:Demo_assets(也就是:PDF文件名_assets),里面存放识别出来的图片,这些图片会自动插入到Markdown(md)文档里。
4、md再编辑
当识别完,生成md文档后,你可以点击md,看到md文档的源码,如果你不习惯源码方式查看,可以点击右上方的“铅笔”图标,切换到可视化阅读器,里面可以所见即所得的看到文字、表格和图片,你还可以方便的进行编辑。